RAG fiable: separar recuperación, generación y evaluación
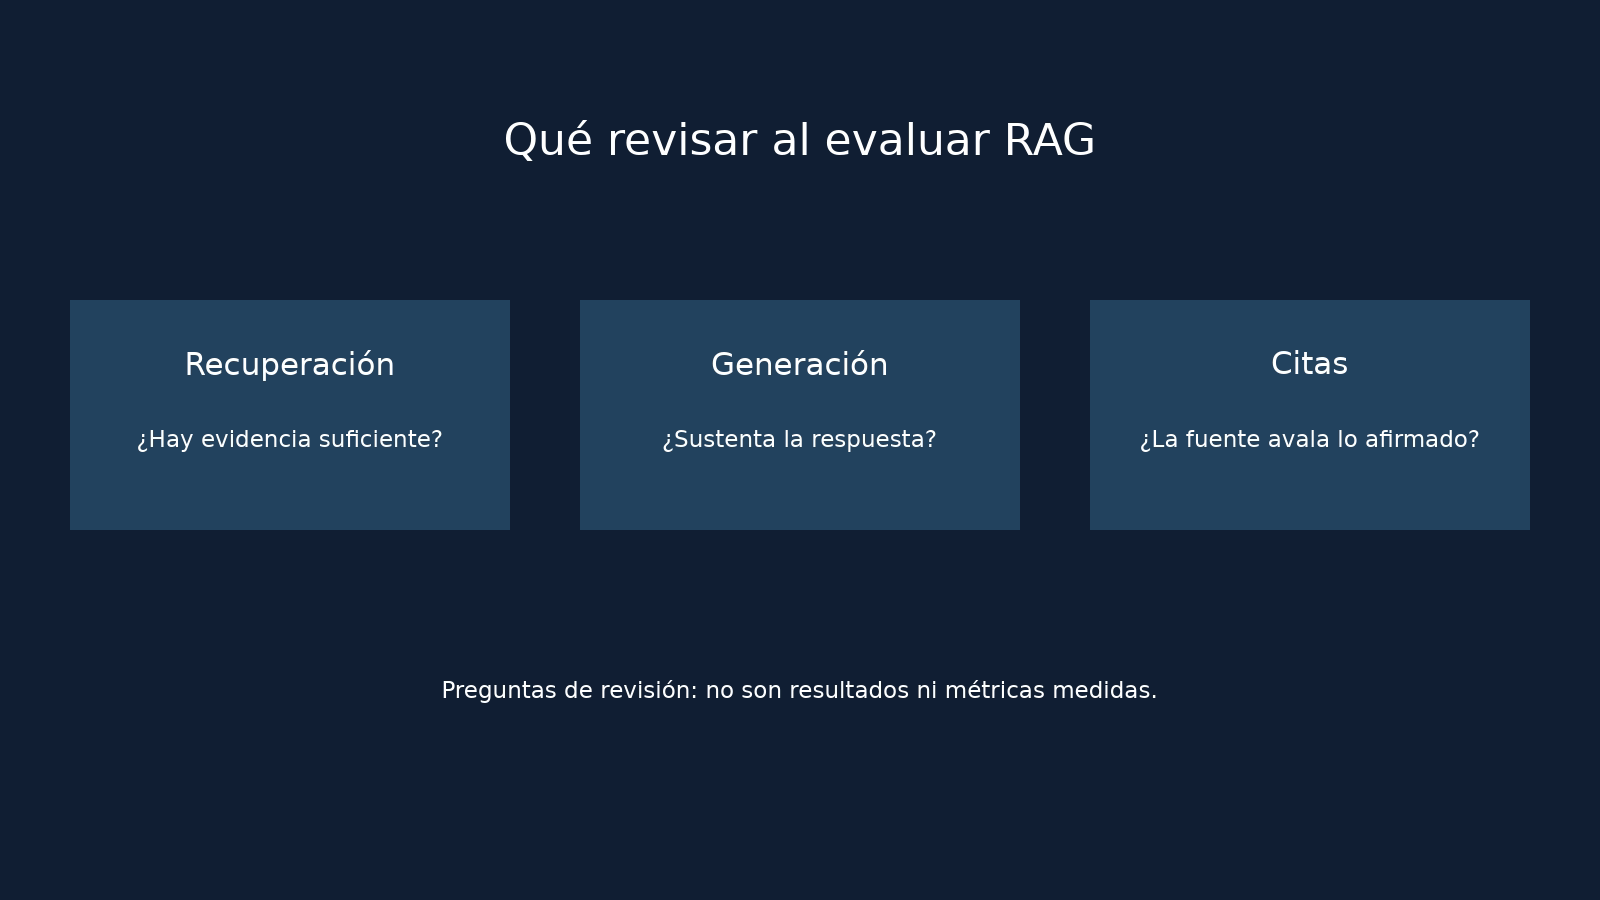
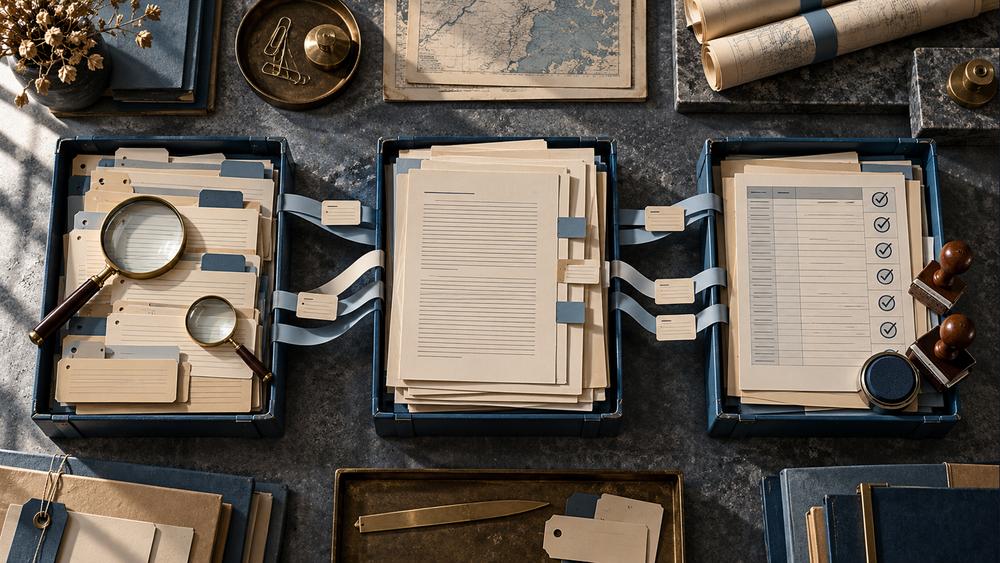
Un sistema de recuperación aumentada no se corrige con un único ajuste de prompt. Su resultado depende de tres capas que conviene tratar por separado: recuperación, generación y evaluación. Si se mezclan, una respuesta errónea puede atribuirse al modelo cuando el problema estaba en el índice, o celebrarse una búsqueda correcta aunque la respuesta final haya inventado una conclusión.
El patrón RAG combina una búsqueda sobre datos propios con un modelo que redacta usando el contexto recuperado. La documentación de Microsoft Foundry describe precisamente esa secuencia: recuperar información, incorporarla como contexto y generar una respuesta que puede enlazar de vuelta al contenido fuente. La arquitectura parece lineal, pero cada fase tiene objetivos, señales de calidad y fallos propios.
1. Recuperación: encontrar evidencia antes de redactar
La recuperación responde a una pregunta limitada: ¿llegaron al contexto los fragmentos necesarios para contestar? No determina aún si la contestación será clara, prudente o fiel. Su unidad de trabajo es el fragmento recuperado, no el párrafo final que ve la persona usuaria.
El diseño empieza en el corpus. Hay que decidir qué documentos entran, cómo se actualizan, qué metadatos conservan y cómo se dividen en chunks. Un chunk demasiado corto puede perder una excepción, una tabla o la relación entre una regla y su condición. Uno demasiado largo puede introducir ruido, gastar presupuesto de contexto y hacer menos preciso el ranking. No existe un tamaño universal: el criterio útil es que el fragmento conserve la unidad mínima de significado que una respuesta necesita citar.
Embeddings, índice y consulta
Los embeddings representan texto como vectores numéricos para búsqueda semántica y RAG. La guía de Ollama indica que sus vectores para el endpoint de embeddings se entregan normalizados y recomienda similitud coseno para muchos casos de búsqueda semántica. También recomienda usar el mismo modelo de embeddings al indexar y al consultar. Esa consistencia es una decisión de recuperación: cambiar solo un lado altera el espacio de comparación y vuelve difícil interpretar una caída de resultados.
Una búsqueda vectorial no debería convertirse automáticamente en la única estrategia. Para preguntas con nombres exactos, códigos, números de versión o términos muy específicos, la coincidencia por palabras puede aportar una señal necesaria. Para preguntas conceptuales, la señal semántica suele ser más útil. Un diseño híbrido, filtros por metadatos y una etapa de reordenación pueden ser hipótesis razonables, pero deben compararse contra un conjunto de consultas representativas, no adoptarse por intuición.
Fallos que pertenecen a recuperación
- El documento correcto no fue indexado, está desactualizado o se eliminó un metadato decisivo.
- La división separó una afirmación de sus condiciones, negaciones o referencias.
- Los primeros resultados responden a términos parecidos, pero no a la intención de la pregunta.
- Se recuperan demasiados pasajes y la evidencia importante queda diluida.
- La consulta exige una restricción temporal, de producto o de audiencia que el índice no filtra.
Cuando ocurre uno de estos casos, pedir al modelo que “sea más preciso” no recupera la evidencia ausente. Primero hay que inspeccionar la consulta, los chunks devueltos, sus identificadores, la posición en el ranking y los metadatos. Esa traza permite saber si la generación recibió material suficiente.
2. Generación: responder solo con lo que sostiene el contexto
La generación comienza después de seleccionar pasajes. Aquí la pregunta es distinta: ¿la respuesta expresa correctamente la evidencia recuperada, sin añadir hechos no respaldados? El modelo transforma contexto en lenguaje; no convierte una recuperación imperfecta en una fuente fiable.
El contrato del prompt debe ser operativo. Debe indicar qué hacer si los pasajes no contienen la respuesta, cómo distinguir una inferencia de un dato explícito y cómo incluir citas o referencias a los fragmentos usados. La documentación de Microsoft Foundry advierte que pueden producirse respuestas inexactas incluso con grounding y propone citas e instrucciones claras para ceñirse al contenido recuperado. Por ello, una cita no es decoración editorial: es una relación comprobable entre una afirmación y su evidencia.
Conviene obligar al sistema a reconocer la insuficiencia. Una salida como “no encuentro base suficiente en los documentos recuperados” es preferible a una respuesta completa pero fabricada. También conviene evitar que el modelo mezcle conocimiento general con contenido del corpus sin marcar la procedencia. En entornos donde el corpus es la autoridad, la respuesta debe basarse exclusivamente en los pasajes proporcionados.
Presupuesto de contexto y selección
Más texto no garantiza más fidelidad. La documentación sobre RAG señala que los pasajes pueden consumir rápidamente el límite de tokens y sugiere filtrado, ranking o resumen para controlar ese presupuesto. La consecuencia práctica es separar dos decisiones: cuántos candidatos recuperar y cuántos fragmentos finales entregar al modelo. El primer número protege la cobertura; el segundo protege la atención del modelo y la latencia.
Las citas deben conservar el identificador estable de la fuente, el fragmento o sección y, cuando proceda, su enlace. No basta con mostrar una lista de documentos al final: una persona revisora debe poder asociar cada afirmación sustantiva con el pasaje que la respalda. Si una frase depende de dos fuentes, debe reflejar esa dependencia en lugar de atribuirla a una sola.
3. Evaluación: medir cada capa y revisar la cadena
Una evaluación útil no pregunta únicamente si la respuesta “suena bien”. Separa al menos tres objetos: la calidad del ranking, la relevancia textual del contexto y la fidelidad de la respuesta al contexto. La documentación de Microsoft Foundry distingue evaluadores del proceso de recuperación y del sistema, e incluye métricas de ranking como NDCG, XDCG, fidelidad, relevancia máxima y huecos cuando existen etiquetas de verdad de referencia.
| Capa | Pregunta de evaluación | Evidencia para diagnosticar |
|---|---|---|
| Recuperación | ¿Los resultados contienen los documentos relevantes y los sitúan arriba? | Consulta, ranking, identificadores, etiquetas de relevancia y métricas de búsqueda. |
| Contexto | ¿Los chunks seleccionados bastan para responder la pregunta? | Pasajes entregados, cobertura de condiciones y ausencia de ruido crítico. |
| Generación | ¿Cada afirmación está respaldada por el contexto? | Respuesta, citas por afirmación y verificación de grounding. |
| Experiencia | ¿La respuesta resuelve la necesidad sin ocultar incertidumbre? | Claridad, formato, utilidad y comportamiento ante falta de evidencia. |
Las métricas de recuperación necesitan un conjunto de consultas y relevancias etiquetadas si se quiere medir el ranking con precisión. Cuando no existe esa verdad de referencia, puede revisarse la pertinencia textual de los chunks, aunque esa señal no sustituye una etiqueta humana de qué documentos eran realmente necesarios. Del mismo modo, una evaluación de groundedness comprueba alineación con el contexto; no prueba que el corpus sea completo, vigente o correcto.
Un conjunto de pruebas que sí explica fallos
- Reúna preguntas reales y difíciles, incluidas preguntas sin respuesta en el corpus.
- Para cada pregunta, defina la evidencia esperada: documento, sección o fragmento, y las condiciones que no se pueden omitir.
- Registre por separado los candidatos recuperados, los chunks enviados al modelo, la respuesta y las citas emitidas.
- Clasifique el fallo: ausencia de evidencia, ranking débil, contexto insuficiente, afirmación no sustentada, cita incorrecta o formato defectuoso.
- Cambie una variable por iteración —chunking, modelo de embeddings, filtros, ranking o instrucciones— y compare contra el mismo conjunto.
Esta separación reduce conclusiones engañosas. Si el documento esperado no aparece, el problema está antes de la generación. Si aparece pero no se pasa al contexto final, el problema es la selección. Si se pasa y la respuesta lo contradice, el problema pertenece a generación o a su control. Si la respuesta está respaldada pero no satisface la pregunta, hay que revisar la definición de tarea y el conjunto de evaluación.
4. Citas y seguridad: no son una capa posterior
Las citas aportan trazabilidad, pero también exponen el sistema a fuentes defectuosas, contenido irrelevante o instrucciones incrustadas en documentos. La página de riesgos de OWASP incluye debilidades de vectores y embeddings, envenenamiento de datos y manejo inadecuado de salidas entre los riesgos tratados. Para un RAG, eso obliga a controlar procedencia, permisos, proceso de incorporación y presentación de la salida.
Una política mínima consiste en preservar la fuente de cada chunk, aplicar controles de acceso antes de recuperar, revisar qué contenido puede indexarse y validar la salida antes de convertirla en una acción o una interfaz. Las instrucciones encontradas dentro de un documento deben tratarse como contenido recuperado, no como órdenes para cambiar el comportamiento del sistema.
Separar recuperación, generación y evaluación no hace que un RAG sea infalible. Hace algo más útil: permite localizar el fallo, proponer una corrección verificable y conservar la trazabilidad desde la pregunta hasta la evidencia. Un buen sistema no es el que responde siempre; es el que sabe qué encontró, qué puede sostener y cuándo debe abstenerse.