RAG técnico: recuperación, generación y evaluación separadas
Un sistema RAG combina una búsqueda sobre un conjunto documental con la redacción de una respuesta. Su dificultad no está en encadenar ambos pasos, sino en mantenerlos separados para poder inspeccionarlos. Si recuperación, generación y evaluación se mezclan en una única salida, resulta imposible saber si una respuesta incorrecta procede de un documento ausente, de un fragmento mal seleccionado, de una cita mal enlazada o de una inferencia que excede la evidencia.
La unidad de trabajo debe ser una afirmación verificable. Para cada afirmación relevante conviene conservar qué consulta la originó, qué fragmentos fueron recuperados, con qué identificadores, qué pasajes llegaron al contexto del modelo y qué cita se mostró al lector. Esta trazabilidad convierte RAG en un proceso auditable, no en una respuesta aparentemente documentada.
1. Recuperación: diseñar evidencia antes de pedir prosa
La recuperación recibe una consulta y devuelve candidatos documentales. Antes de elegir un índice o un modelo de embeddings, defina el contrato de cada fragmento: contenido, título o ruta, identificador estable del documento, posición, fecha de ingesta cuando exista, versión y permiso de acceso. Sin estos metadatos, una cita puede señalar una fuente correcta pero una revisión equivocada, o revelar contenido al que la persona usuaria no debería acceder.
Chunks con límites semánticos
Un chunk no es solo un bloque de caracteres. Debe conservar suficiente contexto para sostener una afirmación y, al mismo tiempo, ser lo bastante preciso para no arrastrar información ajena. Cortar dentro de una tabla, una condición, una excepción o una lista normativa suele degradar la evidencia. Los encabezados, las secciones y los límites de párrafo son señales útiles para segmentar; el solapamiento puede preservar continuidad, pero también crea duplicados que conviene detectar al presentar resultados.
La consulta también merece tratamiento explícito. Puede normalizarse, descomponerse en subpreguntas o reformularse, siempre registrando la transformación. Una mejora de recuperación que no deja rastro impide reproducir por qué se recuperó un pasaje determinado. Separar recuperación de generación permite revisar la lista de candidatos sin que el estilo del modelo oculte sus carencias.
Qué revisar en un fallo de recuperación
- Cobertura: el documento necesario no estaba indexado, estaba desactualizado o no era accesible para esa consulta.
- Segmentación: la respuesta depende de información dividida entre chunks que nunca llegaron juntos al contexto.
- Representación: la consulta y el documento usan vocabulario distinto, abreviaturas, idiomas o nombres alternativos.
- Ordenación: existe un candidato pertinente, pero queda fuera del número de resultados enviado al generador.
- Filtros: un filtro por producto, fecha, colección o permisos excluye la fuente adecuada.
No conviene diagnosticar estos casos mirando solo la respuesta final. Guarde los candidatos recuperados y sus puntuaciones cuando el sistema las produzca; después revise si falta el documento, si está presente pero mal posicionado, o si fue descartado antes de generar. Son problemas distintos y requieren cambios distintos.
2. Generación: responder dentro del perímetro recuperado
La generación debe recibir una instrucción clara: responder solo con el contexto suministrado, distinguir hechos de interpretación, citar cada afirmación material y declarar insuficiencia cuando la evidencia no alcance. Esto no convierte al modelo en un verificador automático; establece un límite operativo que puede evaluarse.
Una arquitectura práctica pasa al modelo la pregunta, los chunks elegidos y sus metadatos de cita. El modelo produce una respuesta con referencias a identificadores internos; una capa posterior resuelve esos identificadores en enlaces y comprueba que todos proceden del conjunto realmente recuperado. Así se evita que la salida invente una URL o atribuya una frase a una fuente que no estaba en el contexto.
La documentación de Ollama describe una API para modelos locales o alojados y expone, entre otros, los puntos de acceso de chat y embeddings. Esa separación puede servir como base de integración, pero no reemplaza el índice documental ni la evaluación de recuperación. La referencia oficial indica además que el acceso cloud requiere una clave de API, mientras que las solicitudes locales no la requieren: documentación de la API de Ollama.
Citas que aportan evidencia
Una cita útil es específica, resoluble y proporcional a la afirmación. Específica significa que lleva al documento o pasaje que respalda el enunciado; resoluble, que el enlace o identificador puede abrirse para el lector autorizado; proporcional, que no se usa una fuente tangencial para justificar una conclusión más amplia.
- Asigne a cada chunk un identificador estable y una procedencia visible para el sistema.
- Exija que cada afirmación factual relevante apunte a uno o varios identificadores recuperados.
- Valide después de generar que los identificadores existen, pertenecen a la consulta y respetan permisos.
- Presente la cita junto a la afirmación, no al final de un párrafo que contiene varios hechos independientes.
- Si dos fuentes discrepan, exponga la discrepancia en vez de seleccionar una sin explicarla.
3. Evaluación: tres preguntas, tres conjuntos de señales
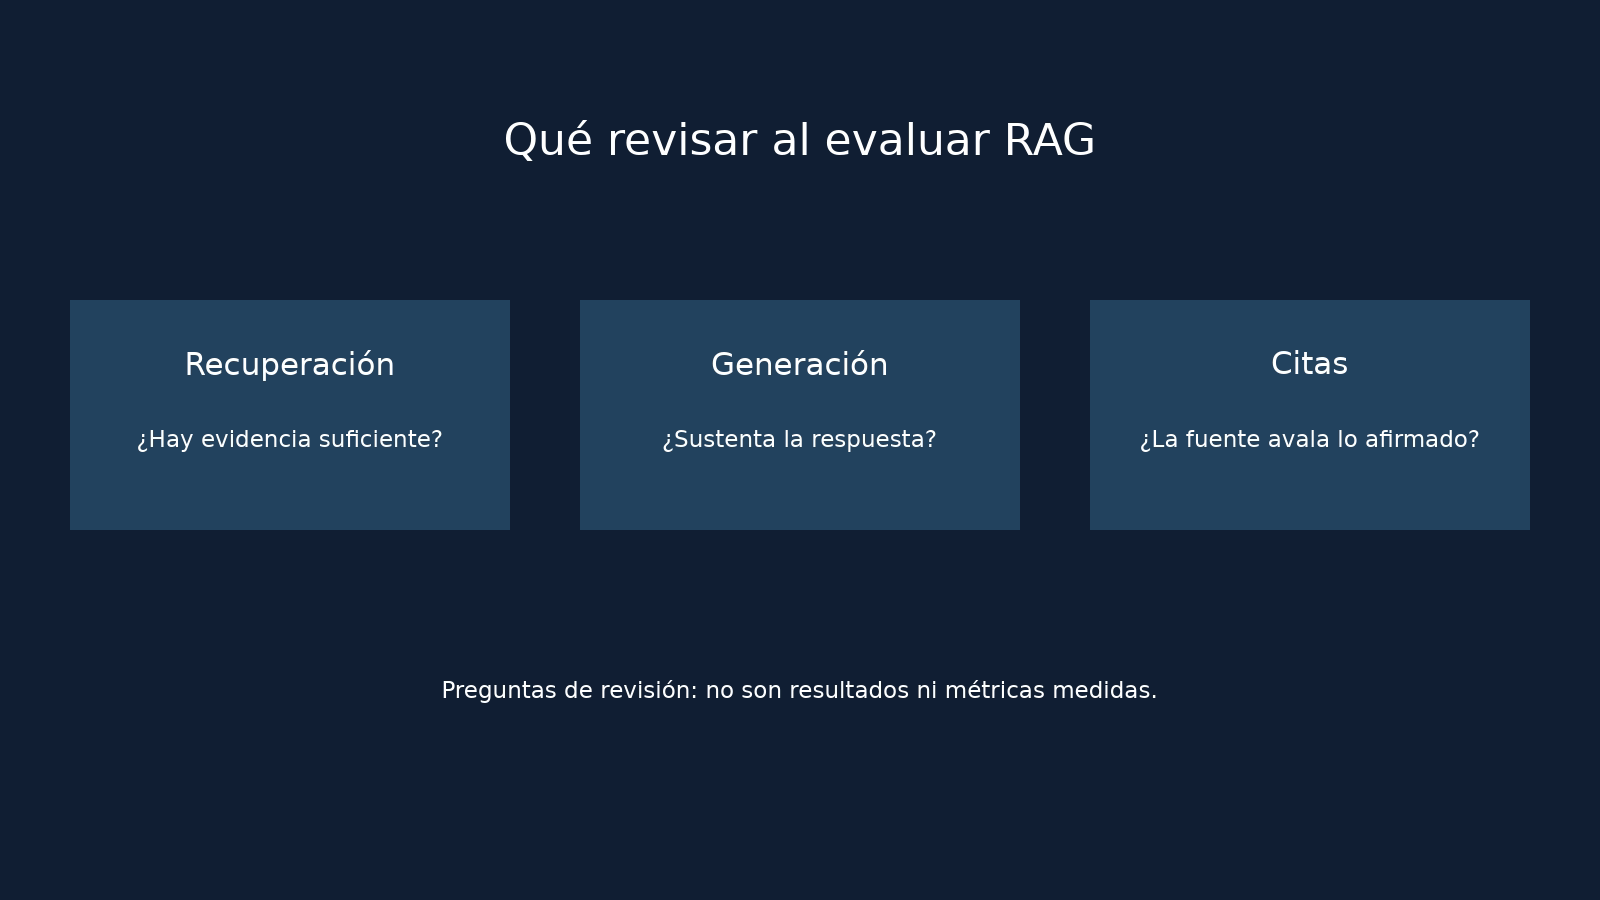
Evaluar RAG como si fuera una única tarea oculta el origen de los errores. La recuperación se evalúa preguntando si el corpus devuelve evidencia pertinente. La generación se evalúa preguntando si la respuesta está respaldada por la evidencia entregada. La experiencia de uso se evalúa preguntando si la cita permite comprobar esa relación sin ambigüedad.
| Capa | Pregunta de evaluación | Artefacto a inspeccionar |
|---|---|---|
| Recuperación | ¿Aparece la evidencia necesaria entre los candidatos? | Consulta, filtros, ranking y chunks recuperados |
| Generación | ¿La respuesta añade afirmaciones no contenidas o no inferibles del contexto? | Respuesta, contexto entregado e identificadores de cita |
| Citas | ¿Cada enlace sostiene exactamente la afirmación cercana? | Texto final, pasaje citado y documento de origen |
| Seguridad | ¿La consulta o el contenido recuperado altera indebidamente las reglas del sistema? | Instrucciones, documentos, permisos y registros |
Los conjuntos de evaluación deben contener preguntas respondibles con fuentes conocidas, preguntas sin respaldo en el corpus y casos con documentos parecidos pero incorrectos. Las preguntas sin respaldo son esenciales: permiten comprobar si el sistema sabe abstenerse. No atribuya una métrica a una mejora sin un protocolo, un conjunto de casos, criterios de relevancia y resultados conservados. Si esos elementos no existen, describa el cambio como una hipótesis de diseño, no como una mejora demostrada.
4. Amenazas y controles de diseño
En RAG, un documento recuperado es contenido de datos, no una instrucción de confianza. Puede incluir frases que intenten redirigir el comportamiento del modelo, pedir que ignore reglas o inducir la revelación de información. El control básico es separar de forma inequívoca las instrucciones de aplicación, la consulta de usuario y el texto recuperado; además, la salida debe pasar por validación de citas, permisos y formato.
Otra amenaza es la exposición entre colecciones o usuarios. Los filtros de autorización deben aplicarse antes de recuperar y no solo al mostrar el resultado. También hay riesgo de fuga de credenciales al conectar componentes. La documentación disponible distingue las rutas cloud y locales y señala el uso de una cabecera de autorización para peticiones cloud; por ello, las claves deben permanecer fuera de documentos indexados, prompts y registros de respuestas: referencia de autenticación y rutas base de Ollama.
El registro es útil para investigar fallos, pero debe minimizar datos sensibles. Conserve lo necesario para reconstruir la recuperación y revisar las citas; limite quién puede leer consultas, fragmentos y respuestas. Trate la ingesta documental como una frontera de confianza: identifique origen, versión y permisos antes de indexar.
Ejemplo conceptual
Ejemplo conceptual, no resultado de pruebas. Una persona pregunta: “¿Qué ruta de API debo usar para una ejecución local?”. El recuperador busca en documentación autorizada, filtra por producto y conserva los chunks que describen las rutas base. El generador recibe solo esos chunks y redacta una respuesta limitada a la información disponible. La salida cita el documento de introducción de Ollama porque en el dossier suministrado se indica la ruta local http://localhost:11434/api y se diferencia del acceso cloud. Si no hubiera un chunk que confirmase una condición adicional, el sistema debería decir que no dispone de evidencia para esa condición, en vez de completarla por plausibilidad.
consulta → recuperar candidatos autorizados → seleccionar evidencia → generar con referencias internas → validar citas y permisos → publicar o abstenerseLista de cierre
- ¿Cada chunk tiene procedencia, versión y control de acceso?
- ¿Puede inspeccionarse la recuperación sin leer la respuesta generada?
- ¿Las citas se validan contra los chunks realmente entregados?
- ¿El conjunto de evaluación incluye ausencia de respuesta, ambigüedad y documentos distractores?
- ¿Las instrucciones del sistema están separadas del contenido recuperado?
Separar las capas no elimina los errores, pero permite localizarlos. En RAG, esa localización es el requisito previo para corregir con método, citar con precisión y rechazar conclusiones que el corpus no sostiene.