Cómo elegir un modelo por tarea sin caer en rankings inventados
Elegir un modelo no consiste en encontrar “el mejor”, sino en reducir incertidumbre para una tarea concreta. Un ranking general mezcla capacidades, configuraciones, presupuestos de cómputo, idiomas, longitudes de entrada y criterios de evaluación que rara vez coinciden con un producto real. El resultado puede ser una recomendación llamativa, pero poco útil para decidir qué desplegar, qué pagar o qué mantener.
La pregunta operativa es otra: ¿qué modelo, arquitectura de servicio y controles permiten resolver esta tarea con una calidad aceptable, un coste asumible y un comportamiento verificable? Ese marco sirve tanto para una API alojada como para una instalación local. También evita una trampa frecuente: atribuir a un modelo lo que en realidad depende del contexto recuperado, del prompt, de la validación de salida o de la interfaz con herramientas.
Empieza por definir la unidad de trabajo
“Necesitamos un modelo para atención al cliente” es una categoría demasiado amplia. Conviene convertirla en unidades observables: clasificar una solicitud, extraer campos de un correo, redactar una respuesta con fuentes, resumir una conversación, traducir una incidencia o ejecutar una secuencia de llamadas a herramientas. Cada una exige cosas distintas.
- Entrada: idioma, longitud, documentos adjuntos, datos estructurados y sensibilidad de la información.
- Salida: texto libre, JSON, etiquetas, código o una acción que deba aprobarse.
- Riesgo: coste de un error, necesidad de trazabilidad y posibilidad de revisión humana.
- Volumen: peticiones por minuto, lotes, picos y previsibilidad de la demanda.
- Restricciones: presupuesto, residencia de datos, hardware, licencia e integración existente.
Con esa ficha, la elección deja de ser una comparación abstracta. Para extracción de campos, por ejemplo, interesan más el formato estable, la tasa de registros válidos y el tratamiento de casos incompletos que una demostración brillante de conversación. Para asistencia sobre documentación interna, el problema central puede ser recuperar el pasaje correcto antes de generar una respuesta.
Separa generación, recuperación e inferencia
Un sistema de consulta documental suele contener al menos tres decisiones: el modelo que convierte el texto en vectores, el índice y la búsqueda, y el modelo que redacta la respuesta. Cambiar cualquiera de ellas altera el resultado. RAG combina búsqueda y modelos de lenguaje para fundamentar respuestas en datos proporcionados por la aplicación; no elimina por sí solo la posibilidad de errores, por lo que las citas, las instrucciones claras y la evaluación siguen siendo necesarias.
La documentación de Microsoft Foundry describe ese flujo como recuperación de contenido relevante, incorporación de ese contenido a la entrada y generación basada en él. También señala límites prácticos: una recuperación deficiente, pasajes excesivos y la latencia del índice pueden degradar el sistema.
Para embeddings, la consistencia importa más que la popularidad del nombre. La guía de Ollama recomienda usar el mismo modelo de embeddings al indexar y al consultar, y usar similitud coseno para muchos casos de búsqueda semántica. Sus vectores del endpoint de embeddings se devuelven normalizados, un detalle que afecta al cálculo y a la elección de almacenamiento. No es razonable proclamar vencedor a un modelo de chat si la recuperación, que es otra pieza, no ha sido medida con consultas representativas.
Elige por familias de tarea, no por una clasificación única
Redacción y transformación de texto
Para reescritura, resumen, clasificación asistida o respuestas con una plantilla, prioriza obediencia a instrucciones, consistencia de tono, control de longitud y capacidad de producir una estructura verificable. Construye un conjunto de ejemplos reales, incluyendo entradas ambiguas y casos límite. Evalúa si el resultado cumple requisitos, no si suena persuasivo.
Extracción y salida estructurada
Cuando el producto consume datos, el contrato de salida es parte de la tarea. Define esquema, campos obligatorios, valores nulos permitidos y reglas de rechazo. Mide porcentaje de respuestas parseables, exactitud de cada campo y coste de reparación. Una salida aparentemente correcta que rompe el proceso posterior cuenta como fallo. Conviene separar la generación de una validación determinista y reenviar únicamente los errores concretos si se permite un segundo intento.
Consulta sobre conocimiento propio
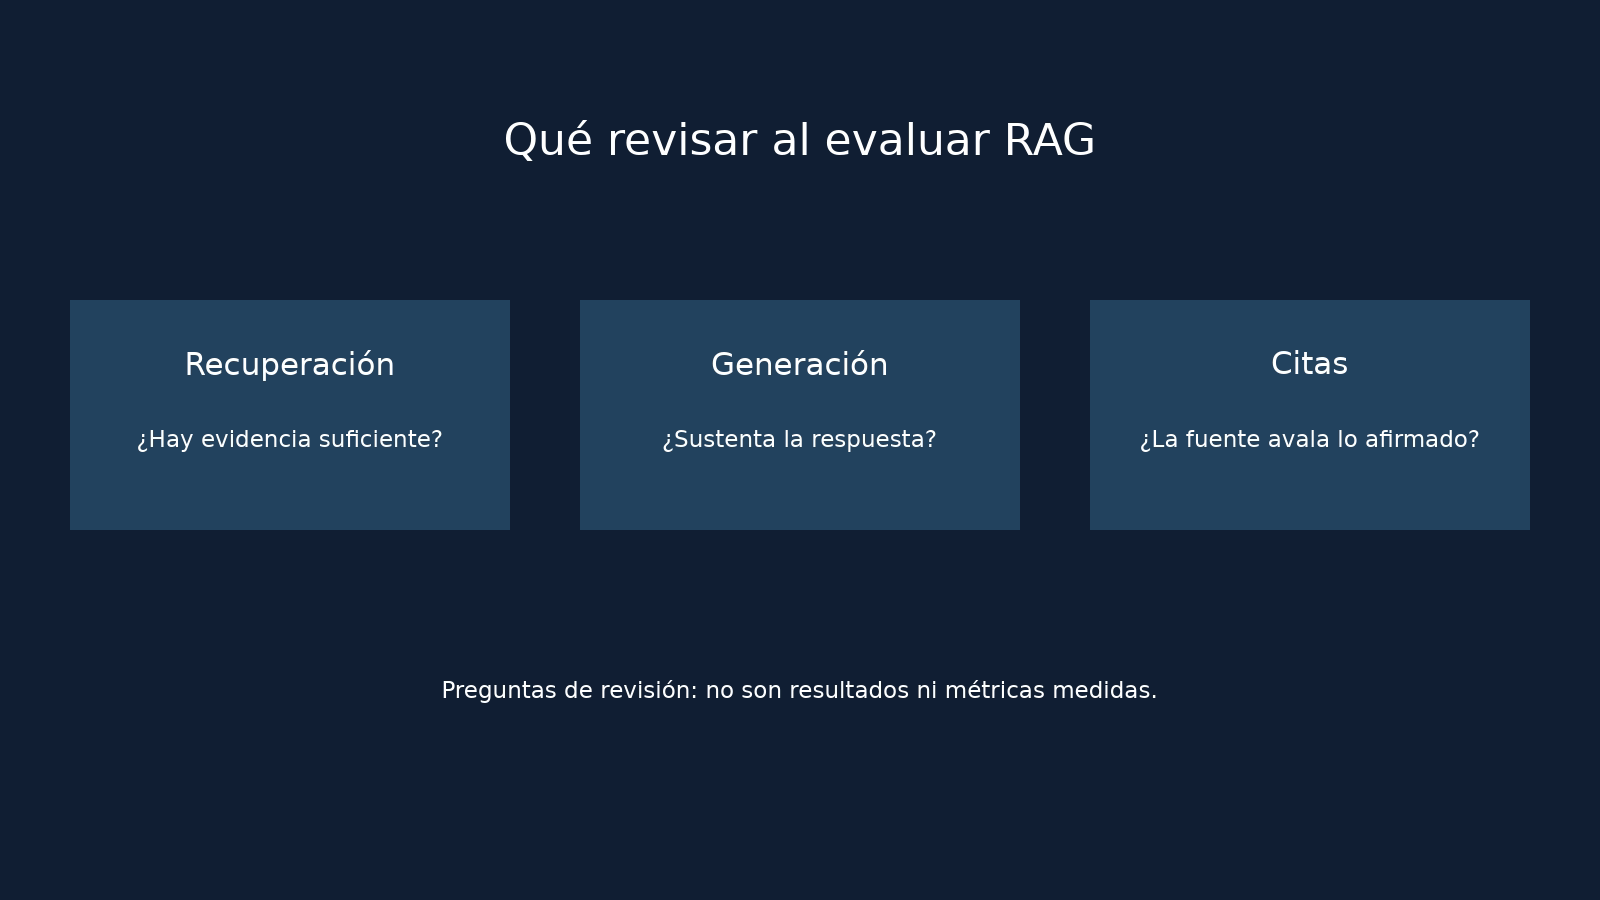
En RAG, prepara preguntas cuya respuesta esté en los documentos y otras cuya respuesta no exista. Mide recuperación antes de valorar la prosa: si el pasaje relevante no aparece entre los resultados, cambiar el modelo generativo no corrige el problema. Después mide fidelidad al contexto, presencia de citas o referencias internas y abstención cuando no hay evidencia suficiente.
Código y uso de herramientas
Una tarea de código no se reduce a generar un fragmento. Puede requerir leer un repositorio, conservar contexto, invocar herramientas y detenerse ante una operación arriesgada. Por eso el éxito debe definirse con pruebas del proyecto, revisiones, permisos y reversibilidad. Las afirmaciones de proveedores pueden orientar una lista inicial, pero no sustituyen la validación en el entorno donde se ejecutará el flujo.
La memoria tiene varias capas y cada una cuesta
“Tiene mucho contexto” no equivale a “recuerda bien”. Hay al menos cuatro capas: la ventana de contexto de una petición, el historial de conversación que se reenvía, la memoria persistente guardada por la aplicación y el conocimiento recuperado desde un índice. Cada capa consume recursos, añade posibles errores de relevancia y exige políticas de privacidad.
Como ejemplo de especificación documentada, la tarjeta de Llama 3.1 8B Instruct declara una longitud de contexto de 128k y soporte para español entre varios idiomas. Eso es una capacidad publicada, no una garantía de que cualquier conversación extensa mantenga todos los detalles útiles. Diseña resúmenes de estado, recuperación selectiva y pruebas de información perdida antes de convertir el contexto máximo en requisito de producto.
Coste: mide la operación completa
El precio por token es sólo una parte de la ecuación. En un servicio alojado hay que contar entrada, salida, reintentos, contexto recuperado, llamadas a herramientas y observabilidad. En un despliegue local, el coste se desplaza a hardware, energía, almacenamiento, operación, concurrencia y tiempo de mantenimiento. La opción local puede reducir exposición de datos o dar control operativo, pero no es automáticamente barata ni sencilla.
La API de Ollama documenta acceso a modelos locales y alojados, con servidores locales en localhost y acceso directo a nube con autenticación. Esta compatibilidad permite aislar la capa de aplicación del modo de ejecución, pero no elimina las diferencias de latencia, disponibilidad, cuotas ni gobierno de datos. Para inferencia local de modelos de lenguaje en C/C++, llama.cpp se presenta como un proyecto de inferencia; su presencia en la arquitectura debe evaluarse por compatibilidad y operación, no como una promesa genérica de rendimiento.
Un protocolo breve para decidir sin inventar rankings
- Define una tarea y un criterio de aceptación cuantificable.
- Reúne ejemplos reales anonimizados, con casos normales, difíciles y prohibidos.
- Fija una configuración por candidato: prompt, límite de salida, herramientas y estrategia de recuperación.
- Evalúa calidad por dimensión: corrección, formato, seguridad, abstención y utilidad para la persona usuaria.
- Registra latencia de extremo a extremo, tokens, fallos, reintentos y coste por tarea completada.
- Revisa licencia, tratamiento de datos, portabilidad y esfuerzo de operación.
- Elige el candidato que cumple el umbral con menor complejidad total, no el que gana una etiqueta global.
La comparación debe mantenerse honesta: fecha del conjunto de casos, versión o identificador del modelo, configuración y condiciones de ejecución. Si se usan alias que pueden cambiar, documenta ese riesgo; la documentación de xAI distingue alias que siguen versiones estables o más recientes de referencias fechadas pensadas para consistencia. La misma idea es útil en cualquier proveedor: reproducibilidad y actualización automática son decisiones distintas.
Un modelo adecuado no es el que parece superior en una tabla universal: es el que supera un umbral explícito en una tarea delimitada y puede operarse con los controles que el producto necesita.
El resultado puede ser una combinación: embeddings especializados para recuperar, un modelo contenido para clasificar, otro para redactar casos complejos y validadores convencionales para las reglas duras. Esa arquitectura suele ser más defendible que delegar todo en una única comparación de marketing. Elegir por tarea obliga a explicitar qué se valora, qué se mide y qué riesgos se aceptan; precisamente por eso produce decisiones técnicas más sólidas.